Що шукають сканери вразливостей: розбір 12 тисяч запитів до сайту за 42 години
 Марко Федоренко
На початку листопада я розібрав access-логи цього сайту і порахував запити сканерів вразливостей. З 4 по 6 листопада, за 41,7 години, їх набралося 12 247 від 58 IP-адрес. Це приблизно 5 запитів щохвилини, вдень і вночі. Сканерам байдуже, що стоїть на сайті, бо вони проходять готовий список адрес на кожному домені.
Нижче розбір цих логів: що шукають, як маскуються і як знаходять адреси, яких ніде не публікували. Деякі цифри взято з ширшого періоду, і біля кожної вказано, з якого. Наприкінці є чекліст для тих, хто запускає проєкти з Cursor, Claude Code чи Lovable.
Скільки запитів роблять сканери вразливостей і що вони шукають?
За 41,7 години сканери зробили 12 247 запитів, і найбільше їх цікавили WordPress, .env і ключі хмарних сервісів. У таблиці ці запити розкладено за типом цілі. Частина запитів не підпала під жодну категорію, тому сума менша.
| Що шукали | Запитів | Приклади адрес |
|---|---|---|
| WordPress і PHP | 4 707 | /wp-login.php, /xmlrpc.php, /wp-admin/ |
Файли .env | 4 509 | /.env, /.env.production, /backend/.env |
| Ключі хмарних сервісів | 882 | /.aws/credentials, /serviceAccountKey.json |
| Конфіги Docker і хостингів | 719 | /docker-compose.yml, /netlify.toml, /vercel.json |
Папка .git | 261 | /.git/config, /.git/HEAD |
| Службові файли Vite, Next.js, Astro | 254 | /.vite/manifest.json, /.next/.env |
| GraphQL | 200 | /graphql |
| Обхід каталогів | 79 | /....//....//.env, /proc/self/environ |
WordPress лідирує, бо це найпоширеніша CMS у світі. Сканеру простіше відправити зайвий запит, ніж визначати CMS. .env відстає зовсім трохи. Для сканера це найвигідніша ціль: один запит, і якщо файл відкритий, у відповідь приходять готові паролі та ключі.
Навіщо сканерам файл .env і чому це ризик для вайбкодерів?
Сканери шукають .env, бо в ньому лежать секрети проєкту: ключі OpenAI чи Anthropic, пароль до бази, токен Stripe. AI-асистенти зазвичай створюють його на самому старті проєкту. Проблема з’являється на деплої. Якщо файл потрапив у папку, яку віддає вебсервер, його може завантажити будь-хто.
У логах 219 різних варіантів шляху до цього файлу. Серед них є /.env.local, /api/.env, /static//app/.env і /admin%2F.env. Останні два розраховані на сервери, які неправильно обробляють подвійні слеші чи закодовані символи. Схоже, ці списки складають під типові структури проєктів.
Окремо сканери шукають ключі саме до AI-сервісів. У логах є запити до /.env.openai, /.env.anthropic і /llm/.env. 1 листопада одна IP-адреса за 5 секунд перебрала 14 адрес, схожих на API AWS Bedrock: /api/bedrock, /api/v1/foundation-models, /api/inference-profiles. Чужий ключ до моделі легко перетворити на гроші, бо платить за генерацію власник ключа.
Чому сканери запитують папки .astro, .next і .vite?
Ці запити перевіряють, чи вебсервер віддає всю папку проєкту замість папки збірки. /.vite/manifest.json сканери запитали 87 разів, /.astro/manifest.json 58 разів, /.next/.env 52 рази. Папки .astro і .next лежать у корені проєкту, поруч із .env і package.json. З інтернету вони доступні лише при такій помилці в налаштуваннях.
Правильна схема проста. Вебсервер дивиться в dist, build чи out, а вихідний код і .env лежать поза цією папкою. Файл .vite/manifest.json справді буває у збірці, якщо ввімкнено build.manifest. Секретів у ньому немає, але він показує стек і назви модулів.
Що можна дістати з відкритої папки .git?
З відкритої папки .git можна завантажити весь репозиторій разом з історією комітів. Для цього є готові утиліти на кшталт git-dumper. Сканери запитали цю папку 261 раз, серед них /.git/config і /.git/HEAD. Ключ, який колись закомітили і потім видалили, у цій історії лишається. Тому після витоку ключ відкликають і випускають новий, як радить GitHub у своїй інструкції.
Як сканери маскуються під Googlebot і AI-ботів?
Сканери підставляють User-Agent відомих краулерів, і так було в 31% їхніх запитів. Найчастіше сканери представлялися ClaudeBot (576 разів), Googlebot (472), GPTBot (270), OAI-SearchBot (263) і Perplexity-User (255). Ймовірний розрахунок такий: ботів пошуковиків і AI-компаній блокують неохоче. Одна адреса 5 листопада за годину назвалася 15 різними ботами, від Googlebot до Baiduspider.
За IP-адресою підробку видно одразу. З 797 запитів з User-Agent Googlebot за 1–4 листопада лише близько 170 прийшли з адрес, які справді належать краулеру Google. Решта приходила з хмарних машин і шукала .env. За той самий період серед 40 найактивніших адрес сканерів 61% запитів дали мережі Google LLC і ще 33% мережі Microsoft. Сканери працюють з орендованих віртуальних машин у тих самих хмарах, якими користуються всі.
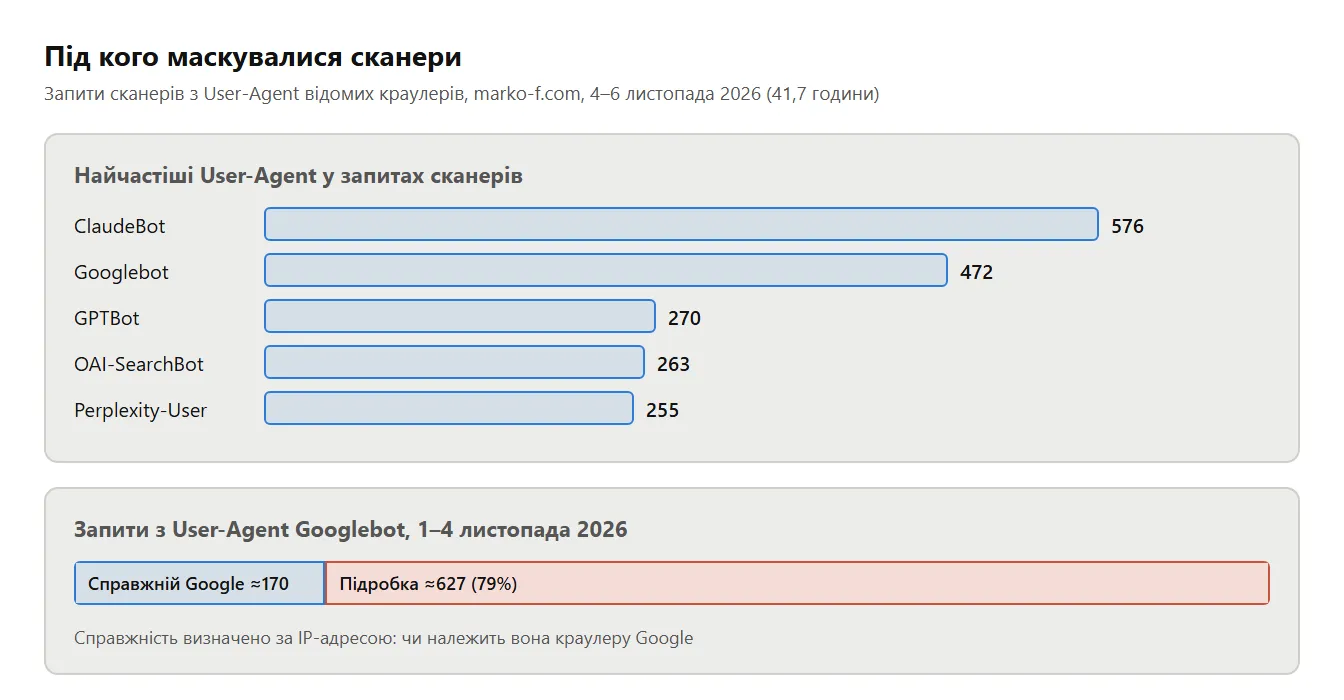
Перевірка займає дві команди. Спершу зворотний DNS для IP, потім прямий запит для отриманого імені. Справжні краулери Google мають ім’я в доменах googlebot.com, google.com або googleusercontent.com, і це ім’я вказує назад на той самий IP.
host 66.249.66.1
# 1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.
host crawl-66-249-66-1.googlebot.com
# crawl-66-249-66-1.googlebot.com has address 66.249.66.1
Якщо домен інший або IP не збігається, це не Google. Для великих логів зручніше звіряти адреси зі списками IP у JSON, які публікують Google і OpenAI. Для SEO-аналітики висновок такий самий: сегмент «боти» за одним User-Agent містить чимало сміття.
Як сканери знаходять піддомени, яких ніде не публікували?
Найімовірніше, сканери беруть такі піддомени з журналів Certificate Transparency. У мене є піддомен, посилань на який я ніде не публікував. За 1–4 листопада він все одно отримав 5 159 запитів.
Ці журнали публічні: кожен публічний TLS-сертифікат, зокрема від Let’s Encrypt, потрапляє туди під час видачі. Сканери стежать за ними і додають нові домени у свої списки. Тому розраховувати на те, що адресу проєкту ніхто не знає, марно. Новий піддомен може отримати перших сканерів раніше за перших відвідувачів.
Що загрожує серверу, крім запитів до сайту?
Сервер постійно намагаються зламати підбором пароля SSH. За 7 днів сервер записав 97 491 невдалу спробу входу. 65 661 з них були під користувачем root. Далі в списку йдуть admin (2 285 спроб), ubuntu (1 771), user (1 136), deploy (758) і test (587). Найактивніша адреса зробила 15 638 спроб.
Друга загроза пов’язана з тим, як зазвичай запускають застосунок на Node.js. Перед ним часто ставлять nginx: він приймає запити з інтернету і передає їх застосунку всередині сервера. Якщо ж у listen() не вказати адресу, застосунок відкриває свій порт для всіх, зокрема для інтернету. Тоді до нього можна звернутися напряму, минаючи nginx з усіма його обмеженнями. На ноутбуці різниці не видно, тому таку помилку легко пропустити.
Найбільше від цього страждають ліміти запитів. Застосунок дізнається IP відвідувача із заголовка X-Forwarded-For, який дописує nginx. При прямому запиті цей заголовок можна написати самому і щоразу вказувати нову адресу. Застосунок вважатиме кожен такий запит новим відвідувачем, і ліміт перестане працювати.
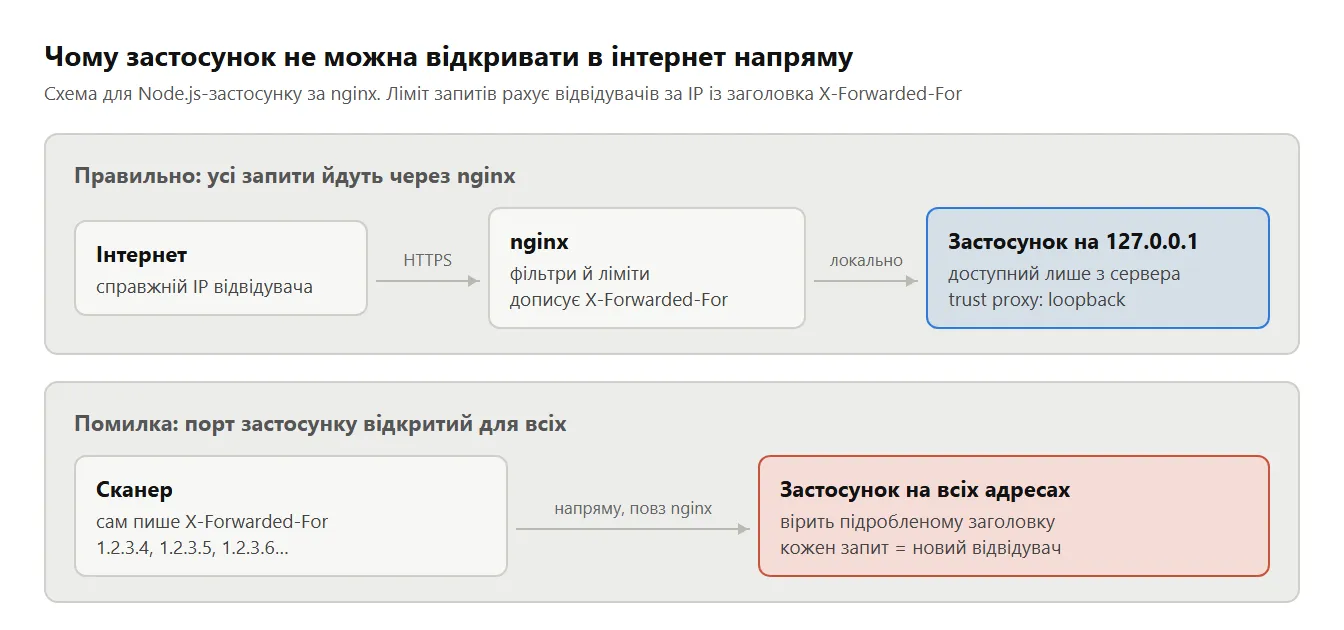
Захист складається з двох кроків. Перший: запускати застосунок на адресі 127.0.0.1, тоді він доступний лише всередині сервера. Другий: в Express ставити trust proxy у значення loopback. З таким налаштуванням застосунок вірить заголовку, лише коли запит передав nginx з того самого сервера.
Що перевірити перед запуском проєкту?
Перед запуском варто пройти 10 пунктів нижче, і більшість із них займає кілька хвилин. Кожен пункт закриває одну з цілей, які видно в логах вище.
- Відкрий
https://твій-сайт/.envіhttps://твій-сайт/.git/HEAD. Обидві адреси мають віддавати 404 або нічого. - Направ вебсервер у папку збірки (
dist,build,out), а не в корінь проєкту. - Не клади секрети в змінні з префіксами
VITE_чиNEXT_PUBLIC_. Vite і Next.js вбудовують такі змінні в JavaScript, який отримує браузер. - Перевір, чи не публікуються source map у production. Відкрий у браузері будь-який JS-файл сайту і допиши до адреси
.map. - Прив’язуй застосунок до
127.0.0.1, якщо перед ним стоїть nginx чи інший проксі. Залиш у фаєрволі відкритими лише порти 22, 80 і 443. - Став
trust proxyв Express уloopbackабо на конкретну адресу проксі. - Входь на сервер по SSH-ключу і вимкни вхід за паролем. Fail2ban заблокує адреси, які перебирають паролі.
- Якщо ключ хоч раз потрапив у git, відклич його і випусти новий.
- Встанови ліміт витрат для ключів OpenAI, Anthropic та інших платних API. Якщо ключ таки витече, рахунок не зросте безмежно.
- Не довіряй User-Agent. Перевіряй ботів за IP і зворотним DNS.
Сканери нікуди не зникнуть, і прибирати їх не треба. Достатньо, щоб у відповідь вони не отримали нічого цінного.
Джерела
Усі цифри в статті взято з логів цього сайту. Поведінку Node.js, Express, Vite і Next.js описано за їхньою документацією. Посилання нижче.
- Логи marko-f.com за 28 жовтня – 6 листопада 2026 року. Власники IP-адрес визначені через ipinfo.io.
- Node.js, документація
server.listen(): без вказаного host сервер приймає з’єднання на всіх адресах. https://nodejs.org/api/net.html#serverlisten - Express, «Express behind proxies»: значення
trust proxy, зокремаloopback. https://expressjs.com/en/guide/behind-proxies.html - Vite, «Env Variables and Modes»: змінні з префіксом
VITE_потрапляють у клієнтський код. https://vite.dev/guide/env-and-mode - Vite, опція
build.manifest. https://vite.dev/config/build-options#build-manifest - Next.js, «Environment Variables»: змінні
NEXT_PUBLIC_вбудовуються в JavaScript для браузера. https://nextjs.org/docs/app/guides/environment-variables - GitHub Docs, «Removing sensitive data from a repository». https://docs.github.com/en/authentication/keeping-your-account-and-data-secure/removing-sensitive-data-from-a-repository
- Google Search Central, «Verifying Googlebot and other Google crawlers». https://developers.google.com/search/docs/crawling-indexing/verifying-googlebot
- OpenAI, «Overview of OpenAI Crawlers»: User-Agent і списки IP-адрес ботів. https://platform.openai.com/docs/bots
- W3Techs, «Usage statistics of content management systems». https://w3techs.com/technologies/overview/content_management
- RFC 6962, Certificate Transparency. https://www.rfc-editor.org/rfc/rfc6962
Якщо перевіриш свій сайт за чеклістом і знайдеш щось цікаве в логах, напиши мені. Таких даних у відкритому доступі мало.
Матеріали marko-f.com частіше показуватимуться вам у Google Пошуку.